<?xml version="1.0" encoding="utf-8"?><feed xmlns="http://www.w3.org/2005/Atom" ><generator uri="https://jekyllrb.com/" version="3.10.0">Jekyll</generator><link href="https://sergushenkov.github.io//feed.xml" rel="self" type="application/atom+xml" /><link href="https://sergushenkov.github.io//" rel="alternate" type="text/html" /><updated>2024-12-01T13:15:26+00:00</updated><id>https://sergushenkov.github.io//feed.xml</id><title type="html">Hangry DE</title><subtitle>Разбираюсь как работают базы данных</subtitle><entry><title type="html">Advent of Code и не только</title><link href="https://sergushenkov.github.io//advent-of/" rel="alternate" type="text/html" title="Advent of Code и не только" /><published>2024-12-01T00:00:00+00:00</published><updated>2024-12-01T00:00:00+00:00</updated><id>https://sergushenkov.github.io//advent-of</id><content type="html" xml:base="https://sergushenkov.github.io//advent-of/"><![CDATA[<p>Напомню, кто забыл - 1 декабря начинается <a href="https://adventofcode.com/">Advent of Code</a>. Если вдруг не знаете что это - это 25 дней ежедневных заданий на программирование. В день - две задачи. Первая обычно попроще, вторая - отражает рабочие реальности :) когда выясняется что тз на первом шаге <del>совсем не то</del> не совсем то и надо снова решить задачу с учётом новых обстоятельств. Сложность задач варьируется - от совсем простых минут на 15 до довольно неочевидных алгоритмов. Но в целом до уровня hard задач на литкоде точно не дотягивает. Решаю уже третий год - искренне рекомендую попробовать. Я свои две звезды за сегодня уже забрал</p>

<p>Думал ещё одно похожее мероприятие порекомендовать - <a href="https://adventofsql.com/">Advent of SQL</a>. В прошлых запусках не участвовал, но SQL с удовольствием бы порешал, одноко что-то завис на первом задании :( Sample result для примера (конкретно третья строка для Bobby) не сходится с тем, что у меня получилось. Ошибки в своих рассуждениях не вижу, а логика решения примера не прописана - поэтому создаётся впечатление, что сайт сырой</p>]]></content><author><name></name></author><summary type="html"><![CDATA[Напомню, кто забыл - 1 декабря начинается Advent of Code. Если вдруг не знаете что это - это 25 дней ежедневных заданий на программирование. В день - две задачи. Первая обычно попроще, вторая - отражает рабочие реальности :) когда выясняется что тз на первом шаге совсем не то не совсем то и надо снова решить задачу с учётом новых обстоятельств. Сложность задач варьируется - от совсем простых минут на 15 до довольно неочевидных алгоритмов. Но в целом до уровня hard задач на литкоде точно не дотягивает. Решаю уже третий год - искренне рекомендую попробовать. Я свои две звезды за сегодня уже забрал]]></summary></entry><entry><title type="html">Неочевидный SQL - решение count()</title><link href="https://sergushenkov.github.io//count-answer/" rel="alternate" type="text/html" title="Неочевидный SQL - решение count()" /><published>2024-11-25T00:00:00+00:00</published><updated>2024-11-25T00:00:00+00:00</updated><id>https://sergushenkov.github.io//count-answer</id><content type="html" xml:base="https://sergushenkov.github.io//count-answer/"><![CDATA[<p>Напомню, как выглядит таблица</p>

<table>
  <thead>
    <tr>
      <th>id</th>
      <th>c1</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td>1</td>
      <td>null</td>
    </tr>
    <tr>
      <td>2</td>
      <td>null</td>
    </tr>
    <tr>
      <td>3</td>
      <td>null</td>
    </tr>
    <tr>
      <td>null</td>
      <td>id</td>
    </tr>
    <tr>
      <td>null</td>
      <td>null</td>
    </tr>
  </tbody>
</table>

<p>И вот собственно ответ:</p>
<ul>
  <li>count(*) = 5</li>
  <li>count(1) = 5</li>
  <li>count(2) = 5</li>
  <li>count(id) = 3</li>
  <li>count(‘id’) = 5</li>
  <li>count(null) = 0</li>
</ul>

<p>Если честно, я правильно ответил только для count(* ) и count(id) - потому что только в таком виде и использую count(). И то, для count(*) сомневался - потому что последняя строка таблицы с одними null ИМХО не возможна в реляционной теории :)</p>

<p>Про формат count(1) и count(2) - почему то всё время знакомства с SQL думал что это указывают номер столбца вместо прямого указания имени, примерно как в group by или order by (нет). Сам так никогда не делаю (“явное лучше неявного”), поэтому с проблемами не сталкивался.</p>

<p>count(‘id’) и count(null) - в таком виде тоже никогда не использовал, так что сомневался будет ли это вообще работать</p>

<p>Теперь, как это работает на самом деле.</p>

<p><strong>count(*)</strong> считает все строки, независимо от их содержимого</p>

<p><strong>count(column_name)</strong> - подсчитывает количество строк, где значение в указанном столбце не равно null</p>

<p>Все остальные варианты попадают под <strong>count(expression)</strong> - подсчитывает количество строк, для которых выражение не вычисляется в null. Если выражение всегда возвращает не-null (например, константа или литерал), то все строки будут посчитаны.</p>]]></content><author><name></name></author><summary type="html"><![CDATA[Напомню, как выглядит таблица]]></summary></entry><entry><title type="html">Неочевидный SQL - count()</title><link href="https://sergushenkov.github.io//count/" rel="alternate" type="text/html" title="Неочевидный SQL - count()" /><published>2024-11-22T00:00:00+00:00</published><updated>2024-11-22T00:00:00+00:00</updated><id>https://sergushenkov.github.io//count</id><content type="html" xml:base="https://sergushenkov.github.io//count/"><![CDATA[<p>Даже если не ищу работу - с удовольствием хожу на собеседования (к слову - рекомендую всем делать это регулярно). И на последнем меня красиво посадили в лужу. Нашёл просто грубейший пробел в своих знаниях - как работает count(), и как ни странно - на качестве моих SQL-запросов это никак не отражалось все эти годы :)</p>

<p>Предположим, что у нас есть такая таблица</p>

<table>
  <thead>
    <tr>
      <th>id</th>
      <th>c1</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td>1</td>
      <td>null</td>
    </tr>
    <tr>
      <td>2</td>
      <td>null</td>
    </tr>
    <tr>
      <td>3</td>
      <td>null</td>
    </tr>
    <tr>
      <td>null</td>
      <td>id</td>
    </tr>
    <tr>
      <td>null</td>
      <td>null</td>
    </tr>
  </tbody>
</table>

<p>Какие значения для неё вернут count(*), count(1), count(2), count(id), count(‘id’), count(null)?</p>

<div class="language-sql highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="k">with</span> <span class="n">t</span> <span class="k">as</span> <span class="p">(</span>
 	          <span class="k">select</span> <span class="mi">1</span> <span class="k">as</span> <span class="n">id</span><span class="p">,</span> <span class="k">null</span> <span class="k">as</span> <span class="n">c1</span>
 	<span class="k">union</span> <span class="k">all</span> <span class="k">select</span> <span class="mi">2</span>      <span class="p">,</span> <span class="k">null</span>
    <span class="k">union</span> <span class="k">all</span> <span class="k">select</span> <span class="mi">3</span>      <span class="p">,</span> <span class="k">null</span>
 	<span class="k">union</span> <span class="k">all</span> <span class="k">select</span> <span class="k">null</span>   <span class="p">,</span> <span class="s1">'id'</span>
    <span class="k">union</span> <span class="k">all</span> <span class="k">select</span> <span class="k">null</span>   <span class="p">,</span> <span class="k">null</span>
<span class="p">)</span>
<span class="k">select</span> <span class="k">count</span><span class="p">(</span><span class="o">*</span><span class="p">),</span> <span class="k">count</span><span class="p">(</span><span class="mi">1</span><span class="p">),</span> <span class="k">count</span><span class="p">(</span><span class="mi">2</span><span class="p">),</span> <span class="k">count</span><span class="p">(</span><span class="n">id</span><span class="p">),</span> <span class="k">count</span><span class="p">(</span><span class="s1">'id'</span><span class="p">),</span> <span class="k">count</span><span class="p">(</span><span class="k">null</span><span class="p">)</span> 
<span class="k">from</span> <span class="n">t</span><span class="p">;</span>
</code></pre></div></div>

<p>Правильный ответ, логику рассуждений, и почему мне это было не важно - напишу после выходных.</p>

<p>Если прямо невтерпёж проверить - специально написал через CTE, копируете и выполняете (например здесь - https://sqliteonline.com/)</p>]]></content><author><name></name></author><summary type="html"><![CDATA[Даже если не ищу работу - с удовольствием хожу на собеседования (к слову - рекомендую всем делать это регулярно). И на последнем меня красиво посадили в лужу. Нашёл просто грубейший пробел в своих знаниях - как работает count(), и как ни странно - на качестве моих SQL-запросов это никак не отражалось все эти годы :)]]></summary></entry><entry><title type="html">Ай спик фром май харт</title><link href="https://sergushenkov.github.io//i-speak-from-my-heart/" rel="alternate" type="text/html" title="Ай спик фром май харт" /><published>2024-11-18T00:00:00+00:00</published><updated>2024-11-18T00:00:00+00:00</updated><id>https://sergushenkov.github.io//i-speak-from-my-heart</id><content type="html" xml:base="https://sergushenkov.github.io//i-speak-from-my-heart/"><![CDATA[<p><img src="/./images/2024-11-14-i-speak-from-my-heart.png" alt="" /></p>

<p>В старой шутке - “Какой язык программисту учить первым? - Английский” - не такая уж и большая доля шутки. Реально это полезный навык - актуальная документация, свежие книги и статьи, логи и комментарии в коде доступны только на английском.</p>

<p>С другой стороны - минимальный словарный запас, чтобы пусть медленно, но читать документацию, нарабатывается даже без отдельной учёбы, просто за счёт насмотренности. Статьи и книги прекрасно переводит Яндекс.Переводчик.</p>

<p>Но поменяв компанию, после пяти лет в IT, всё-таки пришёл к тому, что придётся учить всерьёз. Компания зарубежная, на собесе честно предупредил, что худо-бедно могу понять письменный технический текст и на этом всё. Меня заверили что для работы английский язык не нужен - и по факту так и есть. Моя команда - все русскоязычные. Для инженеров и тимлидов из соседних команд, с кем общался - тоже русский родной.</p>

<p>Однако, примерно раз в месяц каждая команда проводит демо - и его проводят на английском. Потому что топы и не-инженерные специалисты - не только русскоговорящие. Официальный язык компании - английский. Кому вести демо из команды - у нас решается жребием, добровольцев нет :) Причём, у новичков после испытательного - первое демо вне очереди.</p>

<p>На фоне моего разговорного английского - <a href="https://www.sports.ru/football/blogs/2286049.html">Виталий Мутко</a> практически нейтив. Немного утешает, что похоже я такой не один - условно каждый десятый примерно так же выступает.</p>

<p>В общем, начинаю занятия на курсах английского, тем более компания компенсирует часть расходов</p>

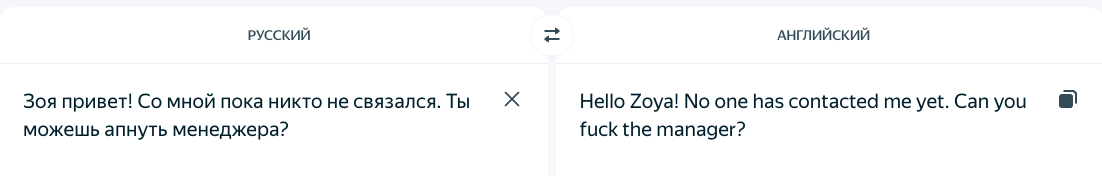
<p>З.Ы. Утром надо было написать сообщение в слаке на английском - как обычно набрал в онлайн-переводчике, осталось скопировать и отправить. Хорошо что прочитал что получилось</p>]]></content><author><name></name></author><summary type="html"><![CDATA[]]></summary></entry><entry><title type="html">Как развить системное мышление?</title><link href="https://sergushenkov.github.io//system-thinking/" rel="alternate" type="text/html" title="Как развить системное мышление?" /><published>2024-11-12T00:00:00+00:00</published><updated>2024-11-12T00:00:00+00:00</updated><id>https://sergushenkov.github.io//system-thinking</id><content type="html" xml:base="https://sergushenkov.github.io//system-thinking/"><![CDATA[<p>Получил пустяковую задачу - прокинуть данные из таблицы-источника в целевую витрину. Точнее, данные и так уже идут, но в некоторых колонках некоторых источников часть данных удаляется. Сделано это потому что целевая витрина - реально огромная (клики по рекламе за месяц) и содержит ещё и несколько проекций (всё работает на Vertica), поэтому невостребованные данные по возможности выкидываются. Эта самая витрина служит источником для личных кабинетов рекламодателей и размещателей рекламы, максимально оптимизирована под из запросы. Ну вот собственно часть текстовых строк, которые раньше затирались пустой строкой, надо довести до итога как есть.</p>

<p>Формально - ни о чём, пару строк в даге поправить. Но на утреннем дейли тимлид предупредил, что прежде чем делать, хорошо бы посчитать на сколько это увеличит объем таблицы (миллиарды строк * несколько проекций, где эта колонка используется). А после - понаблюдать за временем работы дага - насколько оно увеличится. Вроде бы элементарно, но… самому в голову не пришло.</p>

<p>Вот интересно, такой навык (правильно подумать о последствиях) как то прокачивается? Понятно, что <a href="https://yandex.ru/video/preview/13677611431493997107">опыт</a> и количество собранных грабель понемногу прокачивают, но очень уж долго и через <del>упавший прод</del> боль. Думаю в сторону <a href="https://www.youtube.com/watch?v=AVH5Znnnks8">системного мышления</a>, но где взять время :(</p>]]></content><author><name></name></author><summary type="html"><![CDATA[Получил пустяковую задачу - прокинуть данные из таблицы-источника в целевую витрину. Точнее, данные и так уже идут, но в некоторых колонках некоторых источников часть данных удаляется. Сделано это потому что целевая витрина - реально огромная (клики по рекламе за месяц) и содержит ещё и несколько проекций (всё работает на Vertica), поэтому невостребованные данные по возможности выкидываются. Эта самая витрина служит источником для личных кабинетов рекламодателей и размещателей рекламы, максимально оптимизирована под из запросы. Ну вот собственно часть текстовых строк, которые раньше затирались пустой строкой, надо довести до итога как есть.]]></summary></entry><entry><title type="html">Прошёл испытательный срок :)</title><link href="https://sergushenkov.github.io//probation-period-has-passed/" rel="alternate" type="text/html" title="Прошёл испытательный срок :)" /><published>2024-11-06T00:00:00+00:00</published><updated>2024-11-06T00:00:00+00:00</updated><id>https://sergushenkov.github.io//probation-period-has-passed</id><content type="html" xml:base="https://sergushenkov.github.io//probation-period-has-passed/"><![CDATA[<p>Последние две-три недели мир сильно сузился: блог забросил, учёбу запустил — заканчивался испытательный срок, а список задач что-то перестал убывать. Это, в общем-то, логично: то, что было понятно и привычно, сделал сразу, остались темы, в которых нужно разбираться с нуля. Список под ноль так и не добил, но — испытательный срок прошёл успешно. В обратной связи отметили самостоятельность, наметили зоны роста (всё по делу, согласен на все 100%).</p>

<p>За те три месяца, что я здесь, работа нравится всё больше. Задачи большей частью требуют активно включать мозги, и есть на любой вкус: DBA, devops, fullstack, ну и, естественно, классические DE тоже присутствуют. Очень сильная команда. Хорошо выстроены процессы. Реально интерессно работать. Очень доволен — хотя временами самооценка падает, когда затык с какой-то новой темой, зато как она взлетает, когда удаётся допилить задачу :)</p>

<p>Ок, можно выдохнуть, снова вдохнуть и работать дальше.</p>]]></content><author><name></name></author><summary type="html"><![CDATA[Последние две-три недели мир сильно сузился: блог забросил, учёбу запустил — заканчивался испытательный срок, а список задач что-то перестал убывать. Это, в общем-то, логично: то, что было понятно и привычно, сделал сразу, остались темы, в которых нужно разбираться с нуля. Список под ноль так и не добил, но — испытательный срок прошёл успешно. В обратной связи отметили самостоятельность, наметили зоны роста (всё по делу, согласен на все 100%).]]></summary></entry><entry><title type="html">Хардкодим sql-строки</title><link href="https://sergushenkov.github.io//hardcoded-sql-rows/" rel="alternate" type="text/html" title="Хардкодим sql-строки" /><published>2024-10-16T00:00:00+00:00</published><updated>2024-10-16T00:00:00+00:00</updated><id>https://sergushenkov.github.io//hardcoded-sql-rows</id><content type="html" xml:base="https://sergushenkov.github.io//hardcoded-sql-rows/"><![CDATA[<p>В решении sql-задачек удобно, когда есть возможность выполнить запрос и посмотреть, что в итоге получается. Стандартный ход в этой ситуации - создать таблички, возможно темповые, и гонять на них - но лень…</p>

<p>В PostgreSQL, на случай если необходимо захардкодить несколько строк данных, есть удобная команда - https://postgrespro.ru/docs/postgresql/9.6/sql-values, которая просто просится в CTE для таких случаев:</p>

<div class="language-sql highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="k">with</span> <span class="n">t1</span> <span class="p">(</span><span class="n">id</span><span class="p">,</span> <span class="k">describe</span><span class="p">,</span> <span class="n">dttm</span><span class="p">)</span> <span class="k">as</span> <span class="p">(</span>  <span class="c1">-- таблица из двух строк</span>
    <span class="k">values</span> 
        <span class="p">(</span><span class="mi">1</span><span class="p">,</span> <span class="s1">'any text'</span><span class="p">,</span> <span class="n">now</span><span class="p">()),</span> 
        <span class="p">(</span><span class="mi">2</span><span class="p">,</span> <span class="s1">'some text'</span><span class="p">,</span> <span class="s1">'2024-01-01'</span><span class="p">::</span><span class="nb">timestamp</span><span class="p">)</span>
<span class="p">)</span>
<span class="k">select</span> <span class="k">max</span><span class="p">(</span><span class="n">dttm</span><span class="p">)</span> <span class="k">from</span> <span class="n">t1</span>
</code></pre></div></div>

<p>Неожиданно, но в Vertica такого нет и проблема решается громоздким вариантом через union:</p>

<div class="language-sql highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="k">with</span> <span class="n">t1</span> <span class="k">as</span> <span class="p">(</span>  <span class="c1">-- таблица из двух строк</span>
    <span class="k">select</span> <span class="mi">1</span> <span class="k">as</span> <span class="n">id</span><span class="p">,</span> <span class="s1">'any text'</span> <span class="k">as</span> <span class="k">describe</span><span class="p">,</span> <span class="n">now</span><span class="p">()</span> <span class="k">as</span> <span class="n">dttm</span>
    <span class="k">union</span> <span class="k">all</span>
    <span class="k">select</span> <span class="mi">2</span><span class="p">,</span> <span class="s1">'some text'</span><span class="p">,</span> <span class="s1">'2024-01-01'</span><span class="p">::</span><span class="nb">timestamp</span>
<span class="p">)</span>
<span class="k">select</span> <span class="k">max</span><span class="p">(</span><span class="n">dttm</span><span class="p">)</span> <span class="k">from</span> <span class="n">t1</span>
</code></pre></div></div>]]></content><author><name></name></author><summary type="html"><![CDATA[В решении sql-задачек удобно, когда есть возможность выполнить запрос и посмотреть, что в итоге получается. Стандартный ход в этой ситуации - создать таблички, возможно темповые, и гонять на них - но лень…]]></summary></entry><entry><title type="html">copy from file с обработкой данных</title><link href="https://sergushenkov.github.io//copy-from/" rel="alternate" type="text/html" title="copy from file с обработкой данных" /><published>2024-10-10T00:00:00+00:00</published><updated>2024-10-10T00:00:00+00:00</updated><id>https://sergushenkov.github.io//copy-from</id><content type="html" xml:base="https://sergushenkov.github.io//copy-from/"><![CDATA[<p>Наткнулся в Vertica на интересную фишку - <a href="https://www.vertica.com/docs/11.0.x/HTML/Content/Authoring/DataLoad/TransformingDataDuringLoads.htm">обработка данных при загрузке из файла</a>,</p>

<p>Условно - есть файл .csv, там три колонки - (id, a, b), а нам в итоге надо получить две - (id, a + b). В Greenplum пришлось бы использовать промежуточную таблицу - чтобы выгрузить данные AS IS, а уже следующим шагом сделать трансформацию. В Vertica это можно сделать сразу на этапе загрузки</p>

<div class="language-sql highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="k">COPY</span> <span class="k">table</span><span class="p">(</span>
    <span class="n">id</span><span class="p">,</span>
    <span class="n">f_a</span> <span class="n">FILLER</span> <span class="nb">INT</span><span class="p">,</span>
    <span class="n">f_b</span> <span class="n">FILLER</span> <span class="nb">INT</span><span class="p">,</span>
    <span class="n">rez</span> <span class="k">AS</span> <span class="n">f_a</span> <span class="o">+</span> <span class="n">f_b</span>
<span class="k">FROM</span> <span class="s1">'/tmp/file.csv.gz'</span> <span class="k">ON</span> <span class="n">v_bi_node0001</span> 
<span class="p">)</span>
</code></pre></div></div>

<p>Несколько важных моментов:</p>
<ol>
  <li>Поля, которые не идут напрямую в целевую таблицу, надо отметить как FILLER и указать их тип</li>
  <li>Загружать можно в том числе и из сжатых файлов</li>
  <li>Для файла помимо пути, надо указать на какой ноде он лежит (Vertica - распределённая БД). Соответствие между node_name (v_bi_node0001 - в данном случае) и IP ноды можно найти в таблице nodes</li>
</ol>]]></content><author><name></name></author><summary type="html"><![CDATA[Наткнулся в Vertica на интересную фишку - обработка данных при загрузке из файла,]]></summary></entry><entry><title type="html">PXC Strict Mode - жесткий контроль в MySQL</title><link href="https://sergushenkov.github.io//pxc-strict-mode-mysql/" rel="alternate" type="text/html" title="PXC Strict Mode - жесткий контроль в MySQL" /><published>2024-09-19T00:00:00+00:00</published><updated>2024-09-19T00:00:00+00:00</updated><id>https://sergushenkov.github.io//pxc-strict-mode-mysql</id><content type="html" xml:base="https://sergushenkov.github.io//pxc-strict-mode-mysql/"><![CDATA[<p>Есть даг, работающий с очередью тасков - запускает их сообразно своим критериям. Очередь хранится в таблицах внутри БД Airflow. Таблицы не <a href="https://sergushenkov.github.io/there-is-always-another-way/">дефолтные</a>, а специально созданные. Потребовалось расширить функционал - добавил ещё одну таблицу и получил неожиданную ошибку на операции INSERT:</p>
<div class="language-plaintext highlighter-rouge"><div class="highlight"><pre class="highlight"><code>MySQLdb.OperationalError: (1105, 'Percona-XtraDB-Cluster prohibits use of DML command on a table (airflow.dag_launcher_threads) without an explicit primary key with pxc_strict_mode = ENFORCING or MASTER')
</code></pre></div></div>
<p>pxc_strict_mode в зависимости от заданного режима определяет как БД будет относиться к предупреждениям и нештатным функциям:</p>

<p><code class="language-plaintext highlighter-rouge">DISABLED</code> - не выполнять строгие проверки и работать в обычном режиме; ошибки или предупреждения при использовании экспериментальной/неподдерживаемой функции не регистрируются</p>

<p><code class="language-plaintext highlighter-rouge">PERMISSIVE</code> - eсли проверка не пройдена, зарегистрируйте warning и продолжайте работу в обычном режиме</p>

<p><code class="language-plaintext highlighter-rouge">ENFORCING</code> - если проверка не пройдена - отклонить операцию и выдать ошибку</p>

<p><code class="language-plaintext highlighter-rouge">MASTER</code> - то же самое, что <code class="language-plaintext highlighter-rouge">ENFORCING</code>, за исключением того, что проверка явной блокировки таблицы не выполняется</p>

<p>Узнать, текущий режим на сервере:</p>

<div class="language-sql highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="n">mysql</span><span class="o">&gt;</span> <span class="k">SHOW</span> <span class="n">VARIABLES</span> <span class="k">LIKE</span> <span class="nv">"pxc_strict_mode"</span><span class="p">;</span>

<span class="n">Variable_name</span>  <span class="o">|</span><span class="n">Value</span>    <span class="o">|</span>
<span class="c1">---------------+---------+</span>
<span class="n">pxc_strict_mode</span><span class="o">|</span><span class="n">ENFORCING</span><span class="o">|</span>
</code></pre></div></div>
<p>Режим можно поменять (в ущерб надёжности)</p>
<div class="language-sql highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="n">mysql</span><span class="o">&gt;</span> <span class="k">SET</span> <span class="k">GLOBAL</span> <span class="n">pxc_strict_mode</span><span class="o">=</span><span class="n">DISABLED</span><span class="p">;</span> 
</code></pre></div></div>
<p>но лучше дать mySQL то, что она ожидает:</p>
<div class="language-sql highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="n">mysql</span><span class="o">&gt;</span> <span class="k">ALTER</span> <span class="k">TABLE</span> <span class="n">dag_launcher_threads</span> <span class="k">ADD</span> <span class="k">PRIMARY</span> <span class="k">KEY</span> <span class="p">(</span><span class="n">run_id</span><span class="p">);</span>
</code></pre></div></div>]]></content><author><name></name></author><summary type="html"><![CDATA[Есть даг, работающий с очередью тасков - запускает их сообразно своим критериям. Очередь хранится в таблицах внутри БД Airflow. Таблицы не дефолтные, а специально созданные. Потребовалось расширить функционал - добавил ещё одну таблицу и получил неожиданную ошибку на операции INSERT: MySQLdb.OperationalError: (1105, 'Percona-XtraDB-Cluster prohibits use of DML command on a table (airflow.dag_launcher_threads) without an explicit primary key with pxc_strict_mode = ENFORCING or MASTER') pxc_strict_mode в зависимости от заданного режима определяет как БД будет относиться к предупреждениям и нештатным функциям:]]></summary></entry><entry><title type="html">ОФП</title><link href="https://sergushenkov.github.io//ofp/" rel="alternate" type="text/html" title="ОФП" /><published>2024-09-17T00:00:00+00:00</published><updated>2024-09-17T00:00:00+00:00</updated><id>https://sergushenkov.github.io//ofp</id><content type="html" xml:base="https://sergushenkov.github.io//ofp/"><![CDATA[<p>Когда работал в Сбере и в Тинькофф - было очень удобно. Днём, перед обедом, перешёл на несколько этажей - и в моём распоряжении корпоративный спортзал. Штанга, силовая рама, скамья, турник и даже гимнастический зал с матами для разминки. В Вайлдберриз корпоративного спортзала не было, но был просто спортзал в том же здании - тоже хорошо. К слову, спортзал и питание - наверное главная причина почему я предпочитал работать из офиса :) Тренировался по программе Вендлера 5-3-1 - не требует много времени, позволяет быть в хорошей форме и не спеша прогрессировать.</p>

<p>Сейчас на новой работе - 100% удалёнка, офиса в Москве просто нет. Думал ставить короткие тренировки с гирями или собственным весом в паузы между рабочими “помидорками”, но никак не приучить себя к этим самым “помидоркам”. Из-за того что рабочий стек сейчас сильно шире того, в чём я себя чувствую уверенно, куча времени уходит на то, чтобы разобраться в нюансах, и часто просто не оторваться от работы.</p>

<p>В общем, понял что без выделенной тренировки всё же не обойтись. Ходить в спортзал - жалко времени на дорогу. Решил пока обойтись минималистким решением - выбегаю на улицу, круг вокруг прудов в лёгком темпе (чуть больше 3 км), спортплощадка - три сета подтягиваний/отжиманий до отказа, и ещё круг вокруг прудов. Всё вместе чуть меньше часа. В пробежки планирую потом вставить ускорения метров по 100.</p>

<p>Концепт взял из статьи др. Любера - Да здраствует минимализм. Критерием перехода на следующий этап будет способность набрать 100 отжиманий от пола и 30 подтягиваний за 3 подхода. Интересно, сколько времени это займёт - сегодня с утра получилось 9/22, 5/12, 4/10 (подтягивания/отжимания)</p>]]></content><author><name></name></author><summary type="html"><![CDATA[Когда работал в Сбере и в Тинькофф - было очень удобно. Днём, перед обедом, перешёл на несколько этажей - и в моём распоряжении корпоративный спортзал. Штанга, силовая рама, скамья, турник и даже гимнастический зал с матами для разминки. В Вайлдберриз корпоративного спортзала не было, но был просто спортзал в том же здании - тоже хорошо. К слову, спортзал и питание - наверное главная причина почему я предпочитал работать из офиса :) Тренировался по программе Вендлера 5-3-1 - не требует много времени, позволяет быть в хорошей форме и не спеша прогрессировать.]]></summary></entry></feed>