Хэш-таблицы
Довольно типичный для собеседований ответ на вопрос “За счет чего словарь быстро возвращает значение по ключу?” - “За счет использования хэш-таблиц”. Сам так отвечал, имея очень смутное понимание, что же такое эти хэш-таблицы.
Имея неупорядоченный список элементов, мы можем найти нужный методом перебора - сложность O(n) - в худшем случае потребуется перебрать все n элементов. В упорядоченном списке искать можно быстрее, каждый раз проверяя середину диапазона и отбрасывая ту половину, в которой нужного элемента нет - сложность O(log(n)). Выбрать элемент из массива по его числовому индексу можно практически мгновенно - зная адрес первой по порядку (нулевой - если по индексу) ячейки массива в памяти, прибавляем к ней произведение индекса на размер одной ячейки.
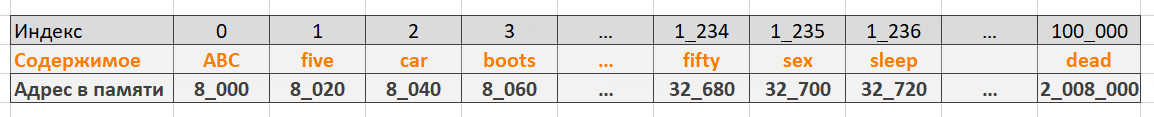
К примеру, нам надо прочитать элемент массива с индексом 1235. Адрес нулевой ячейки - 8000, размер одной ячейки 20 байт. Считаем: 8_000 + 1_235 * 20 = 32_700. Считываем значение из ячейки памяти с адресом 32_700 - ‘sex’. Независимо от количества элементов в массиве, время поиска нужного элемента будет одно и то же - сложность O(1).
Но, в словаре в качестве ключа чаще всего будут не числа, а строки - как их преобразовать в числа? Самый очевидный способ - для каждого ключа-строки считаем сумму числовых значений символов в строке:
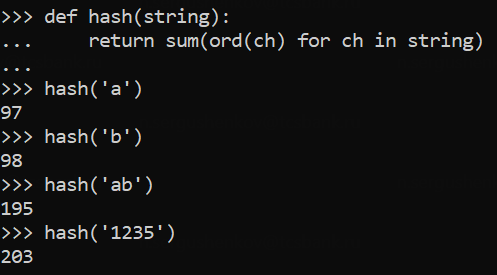
Просто, наглядно и… неправильно. Почему так неправильно и какими должны быть правильные хэш-функции - напишу в следующий раз. Но в целом, для иллюстрации, сейчас подойдёт и такой вариант.
Последний штрих - находим остаток от деления по модулю, равному количеству элементов в хэш-таблице. Т.е., к примеру, если у нас хэш-таблица на 100 элементов (на самом деле они обычно ближе к 100 млн. элементов), то элемент с ключом ‘1235’ (в данном случае это строка, а не число как индекс у массива) попадёт в ячейку с индексом 203 % 100 = 3
Т.е. для каждой пары ключ-значение, например ‘1235’-‘sex’, считаем хэш-функцию для ключа (hash(‘1235’) = 203), для полученного числа находим остаток от деления по модулю на количество элементов хэш-таблицы (203 % 100 = 3) и помещаем в ячейку с таким индексом нужное значение.
В реализации множеств также используются хэш-таблицы, но ключей там нет, хэш-функция считается для самого значения. Например, значение ‘ab’ запишется в ячейку hash(‘ab’) % 100 = 95. Далее, если мы будем проверять, входит ли какое-то значение в множество, мы считаем хэш-функцию для этого значения, находим нужную ячейку и сравниваем его содержимое со значением.
Всё очень просто, пока размер хэш-таблицы значительно больше, чем количество хранимых элементов. Правильная хэш-функция раскидывает элементы по всех таблице, вероятность того что несколько элементов будут претендовать на одну и ту же ячейку крайне мала. Но по мере добавления новых элементов рано (с неправильной хэш-функцией) или поздно мы придём к ситуации, когда нам нужно записать элемент в ту ячейку, где уже что-то записано (коллизия)
Есть два пути, что делать в такой ситуации:
-
Хранить в ячейке хэш-таблицы не один элемент, а список сохраняемых пар ключ-значение (или просто значений - для множества). Тогда при выборке по ключу, сначала мы находим нужную ячейку по хэш-функции ключа, а далее последовательно проверяем список ключей, сохранённых в этой таблице, совпадают ли они с тем значением, которое мы ищем.
-
Если целевая ячейка с индексом А уже занята - сохранить добавляемый ключ в ячейку с индексом А + смещение. Если и она занята, то в ячейку с индексом A + 2*смещение и т.д. Вариант кажется жутко неудобным - но реально используется.
На самом деле существует больше чем два способов разрешения коллизий, но по факту это всё комбинации и вариации этих двух вариантов.